R1 全面就绪 · 显式思维链
DeepSeek - 探索未至之境

探索认知未至之境 DeepSeek 官方入口

围绕 DeepSeek 核心大模型研发体系,全面打通 DeepSeek网页版 在线交互、DeepSeek api开放平台 毫秒级多并发调度,以及完全开源的 DeepSeek Harness 离线双盲评测沙箱,助您直达深度逻辑解题、超长代码重构与通用智能工作流的前沿阵地。
DEEPSEEK_REASONING_CONSOLE.SH
V3-R1 / ACTIVE
DeepSeek 官方深度求索主页控制台界面图
> R1_ENGINE: REASONING_CHAIN_DEPTH = 128K
> STATUS: AIME_2024_MATH_PASS@1 = 79.8%
> COLD_START: ZERO_SUPERVISED_RL
TECHNICAL SPECIFICATIONS

核心算力架构与底层技术突破

基于 DeepSeek 团队自主设计的基础模型算法栈,彻底摒弃盲目扩参数路径,以高效注意力机制与纯强化学习开拓开源通用智能新高地。

SPEC // 01 KV 压缩

MLA 多头潜在注意力

自研 Multi-Head Latent Attention 机制,将推理时键值缓存显存占用压缩至传统架构的 17%,以极少硬件开销支撑百倍并发吞吐。

显存压缩比 5.88x
SPEC // 02 自主进化

纯强化学习驱动

摆脱传统海量人工标注冷启动依赖,模型在纯 RL 奖励信号指引下自主涌现顿悟、多路径穷举、因式反思与边界反例修正能力。

标注样本依赖 0 Tokens
SPEC // 03 细粒度稀疏

256 专家 MoE 路由

拥有 6710 亿总参数,每次 Token 前向计算仅动态激活 370 亿参数,结合无辅助损失负载均衡机制,实现顶级综合推理与经济效能兼得。

激活参数占比 5.5%
SPEC // 04 长程上下文

128K 超长显式推理

原生支持 128,000 Tokens 长窗口,无论是跨多篇技术白皮书、全量项目源码仓重构还是长周期财务报表审计,均能保持完整因果注意力闭环。

上下文窗长 128,000
APPLICATION SCENARIOS

高维攻坚场景 · 从推理到落地实战

当面临无标准答案、跨因果链条的长周期复杂挑战时,DeepSeek 显式思维链能为各领域关键决策提供坚实论据支撑。

系统级代码重构

针对上万行遗留单体工程进行架构解耦,自动梳理全局数据流,生成高覆盖度单元测试与类型守卫契约。

Codeforces 竞赛评分: 2029 (Expert)

奥数与形式化证明

在 AIME 及高等数学竞赛题中展现自主反思链,分步列出引理假设、反例推演并最终完成形式化数学推导。

AIME 2024 Pass@1: 79.8%

跨域法务并购审查

一次性吞吐数百页对赌协议与尽调底稿,精准识别隐性对冲风险、排他性条款冲突及合规敞口。

多文档长程交叉核验闭环

多因子量化策略回测

阅读异构高频行情数据与财报因子,自主编写事件驱动仿真逻辑并完成过拟合惩罚性回溯。

支持 Python/C++ 双向代码仿真

自主多步智能体 (Agent)

配合外部 API、Shell 终端与数据库检索,执行自主规划、中间环境反馈感知与错误自愈长任务。

SWE-bench Verified 达标率领先

私有化离线集群部署

提供全套量化蒸馏模型权重(1.5B ~ 70B),适配国产算力卡与单卡端侧工作站,确保数据物理不出域。

GGUF / vLLM / SGLang 原生支持
MODEL RACK & MATRIX

官方基座模型矩阵与算力规格

横向机架标准化阵列,以明确技术参数与清晰透明资费,满足从日常在线探索到企业级深度生产调用的严苛需求。
STANDARD 通用主力 DeepSeek-V3 通用多语言高吞吐基座模型
架构体系 MLA + 无损 MoE
首字延迟 < 200 ms
知识综合得分 MMLU 88.5%
输出资费 ¥0.28 / 百万
¥0.07 / 1M Tokens 输入
接入接口
EDGE 蒸馏轻量端侧 DeepSeek-R1-Distill 1.5B ~ 70B 开源蒸馏系列
规格分支 Qwen / Llama 骨架
单卡吞吐 120+ Tokens/s
部署方案 Ollama / vLLM
商用许可 MIT 完全免费
开源免费 / 商业无限制
查看权重发布
DeepSeek api开放平台接入配置示意图
API_GATEWAY // OPENAI_PROTOCOL_COMPATIBLE
STEP BY STEP INTEGRATION

开发者极速接入三部曲

01

注册并创建 API Key 凭据

登录 DeepSeek api开放平台控制台,一键生成带有白名单与速率限制策略的高权限 API Key。

02

调整 BaseURL 与认证请求头

接口完全兼容 OpenAI SDK 协议规范,只需切换请求端点至官方安全集群,无须修改任何既有业务代码逻辑。

03

开启 64-Token 前缀缓存与流式推送

针对常见系统 Prompt 自动完成硬盘级对齐缓存,开启 stream 模式实时回传满血版显式推理思维链。

OFFICIAL ACCESS CHANNELS

官方通道矩阵 · 随时随处直达

无论您是普通研究人员、量化工程师还是企业级架构师,均有专属官方通道为您提供稳定连接。

DeepSeek 网页版入口 (Web Terminal)

零门槛免安装,随时在桌面端和移动浏览器开启 R1 深度对话。

直接进入 →

DeepSeek API 开放平台 (Developer Gateway)

为高并发企业业务提供 99.9% 稳定 SLA 承诺,支持批量离线任务。

控制台 →

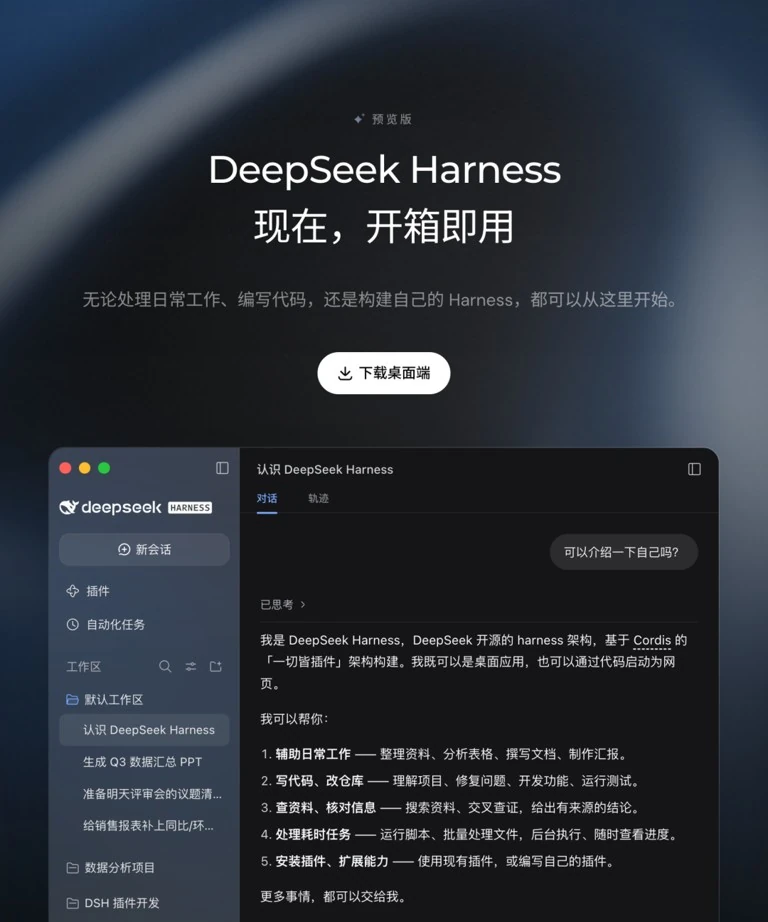
DeepSeek Harness 自动化评测 (Evaluation Sandbox)

开源独立基准套件,支持在内网环境进行模型能力对比与一致性断言。

了解复现 →
DeepSeek 网页版入口与多终端界面展示
PORTAL_MATRIX // UNIFIED_AUTHENTICATION
PROVEN PERFORMANCE

硬核数据量化实测证明

所有指标来自官方集群常态化压测与第三方权威学术榜单独立复现,不掺水、不设防、全透明。

99.8%
API 线上可用率 SLA
多机房容灾自动故障倒换
¥0.14
百万元 Token 缓存资费
行业首创硬盘前缀命中减免
128K
显式推理长上下文
全长范围注意力不衰减
60+
单并发稳定输出 QPS
MLA 显存优化带来高吞吐
进入网页版入口
DEEPSEEK_HARNESS_EVALUATION.CLI
PYTHON 3.11
# 克隆官方独立开源评测框架 Harness
$ git clone https://local-repo/deepseek-ai/DeepSeek-Harness.git
$ cd DeepSeek-Harness && pip install -r requirements.txt

# 执行 AIME 与 MATH-500 双盲确定性评测
$ python -m harness.evaluate \
    --model deepseek-ai/DeepSeek-R1 \
    --tasks aime_2024,math_500,codeforces \
    --num_fewshot 0 --strict_ast_check

[HARNESS] Loaded 500 test cases with verifiable gold standards
[HARNESS] Evaluation Pass@1: 79.8% (Exact Match Verified)
>>> All reasoning chain invariants passed successfully.
REPRODUCIBLE RESEARCH

DeepSeek Harness 闭环评测体系

严格确定性与语法树断言校验

拒绝模糊提示词评测。Harness 采用抽象语法树(AST)与确定性数学求解器进行双重断言,杜绝模型产生套话与幻觉式蒙对现象。

完全解耦防污染与离线双盲机制

评测集采用动态加盐变量机制,严密阻断评测题目被训练语料预先见过的“数据污染”假阳性问题,捍卫严谨科学伦理。

FREQUENTLY ASKED QUESTIONS

常见深度求索问答专栏

采用【问答全开】规范排版,所有解答全量平铺呈现,无需折叠交互,问题用主色,答案用正文色,左齐对齐。

Q1: DeepSeek-R1 为什么在回答问题时会自发展示「深度思考」思维链?

这是通过大规模纯强化学习(Pure RL)在奖励函数引导下自发涌现的认知特征。模型在寻找最优解的过程中,自发学会了将大问题因式拆解、假设引理、遭遇死胡同时回溯、重新验算步骤,从而展现出透明、清晰的显式逻辑因果链,彻底告别盲盒式黑盒猜答案。

Q2: 普通用户如何免费体验满血版 DeepSeek 网页版?

直接点击导航栏的「网页版入口」或页面下方的「进入工作台」,即可在现代浏览器中立即唤起对话工作区。系统支持在线调整“深度思考”开关,无需繁琐本地配置环境,支持长达 128,000 Tokens 的长文档连续上下文交互。

Q3: DeepSeek api开放平台与 OpenAI 接口在工程调用上有何差异?

在协议层完全实现 100% 格式无缝兼容。开发者仅需将环境变量 OPENAI_BASE_URL 替换为官方代理节点,并换用对应 model="deepseek-reasoner" 或 model="deepseek-chat" 即可开箱即用。同时,平台自带 64-Token 整数倍前缀缓存优化,大幅节约多轮长会话的开销。

Q4: 企业私有化部署开源权重时,对显存和算力配置有何基本建议?

对于单机轻量化调试场景,推荐选用 DeepSeek-R1-Distill-Qwen-7B / 14B / 32B 系列蒸馏版本,在单张 24GB 显存消费级显卡(如 RTX 4090)上配合 vLLM 或 Ollama 的 4-bit 量化即可流畅运行;若需部署 671B 完整 MoE 满血版集群,建议选用 8x80GB SXM5 拓扑环境以承载全精度高吞吐推理。

LATEST INSIGHTS & UPDATES

官方技术动态与研究简报

跟踪底层架构前沿演进,见证开源世界推理能力的持续突破。

DeepSeek-R1 正式入驻 API 开放平台并支持显式思维链回传

官方推出 deepseek-reasoner 独立端点,在流式回传中分离 reasoning_content,便于客户端精准渲染思考折叠块。

DeepSeek Harness 开源版本上线并支持 AIME-2024 双盲离线评测

提供完整的语法树检查与确定性数学答案比对沙箱,方便全球开发者在本地环境中独立验证公布指标。

MLA 潜在注意力机制与前缀缓存技术白皮书深度解读

详述 64-Token 整数倍固化前缀缓存在长上下文多轮问答中的显存节省机制与经济效益测算公式。